Liquid-to-chip vs DLC vs D2C: las 3 variantes de enfriamiento líquido que confunden al 90% de los operadores
Los proveedores de CDU, los hyperscalers, y los brochures de NVIDIA mezclan tres términos como si fueran sinónimos: liquid-to-chip, direct liquid cooling, y direct-to-chip. La diferencia técnica entre los tres es del orden de 30 a 80 kW por rack de capacidad, y elegir el equivocado para tu cluster puede significar que tu site llegue a 2 MW de capacidad cuando en realidad necesitas 3.5 MW, o viceversa. Este artículo desglosa las 3 arquitecturas, cuándo conviene cada una, y los criterios objetivos para no caer en el marketing de proveedor.
Las 3 arquitecturas (sin jerga de marketing)
Las tres variantes se diferencian por dónde toca el líquido al silicio y qué componentes del servidor están siendo enfriados activamente. El detalle es más sutil de lo que parece.
Liquid-to-chip (L2C): un cold plate en el CPU, todo lo demás al aire
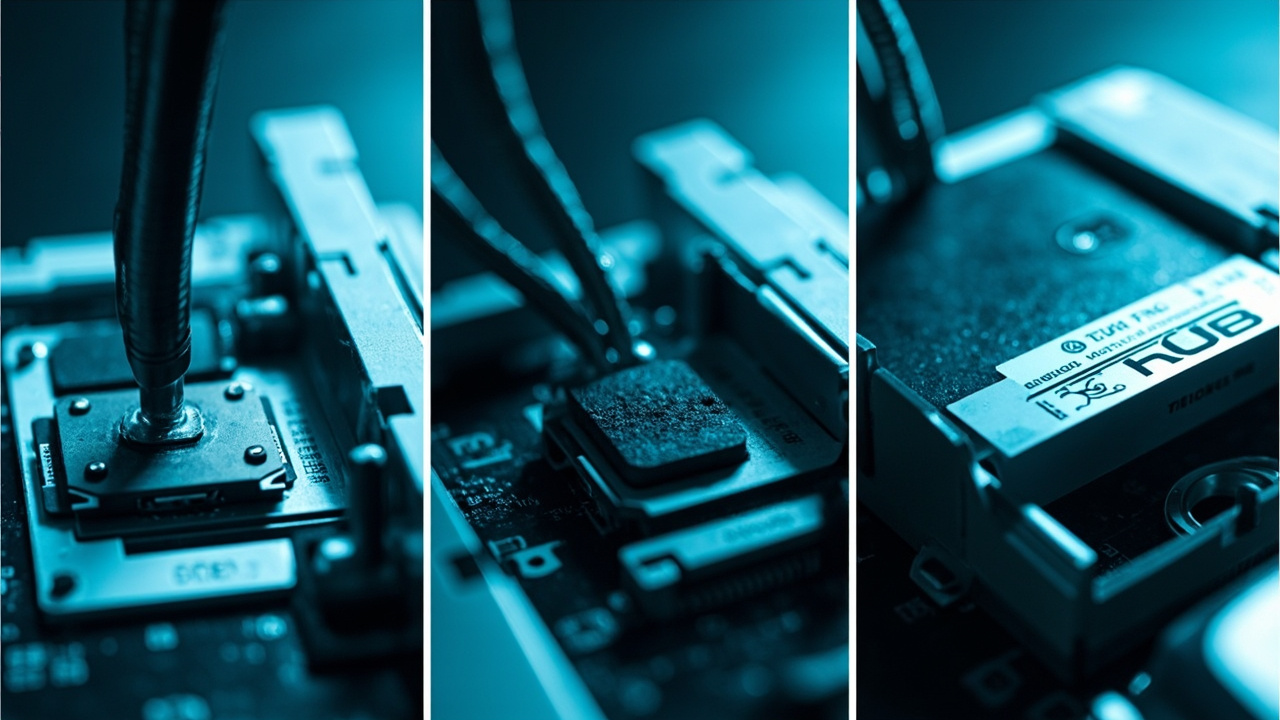
Liquid-to-chip es la variante más conservadora. Se instala un cold plate sobre el CPU (a veces también sobre el chipset o el VRM), y el resto de los componentes del servidor (memoria, discos, NICs, motherboard VRMs) se siguen enfriando por aire. El líquido entra al cold plate retirando el calor del CPU, y el resto del servidor opera dentro del gabinete como un servidor tradicional.
Capacidad por rack: típicamente entre 25 kW y 40 kW. Por encima de eso, los componentes enfriados por aire (memoria, NVMe) empiezan a throttlear porque el aire caliente que sale del cold plate recirculado no es suficiente para enfriarlos. Limitación práctica: si tu rack va a 50+ kW, L2C solo no te alcanza.
Direct Liquid Cooling (DLC): cold plate cubre CPU + memoria + VRM
DLC es un superset de L2C. En lugar de un cold plate solo en el CPU, hay un cold plate extended que cubre CPU, los módulos de memoria (DIMM), y los voltage regulator modules (VRM). El líquido retira el calor del bloque de cómputo entero, no solo del CPU.
Capacidad por rack: típicamente entre 45 kW y 80 kW. La memoria y los VRMs, que son los principales generadores de calor después del CPU, ahora se enfrían activamente. Los componentes que quedan fuera del cold plate (discos, motherboard, NICs) son típicamente de bajo consumo, así que el aire del gabinete los maneja sin problema.
Direct-to-Chip (D2C): cold plate extendido, GPU y HBM incluidos
D2C es la variante más densa, y es lo que NVIDIA llama «direct-to-chip» en sus arquitecturas DGX H100/H200. El cold plate se extiende sobre el CPU, el GPU (o múltiples GPUs), y la memoria HBM que está co-empaquetada con el GPU. En un servidor DGX con 8 GPUs H100, hay 9 cold plates (8 para GPUs + 1 para el CPU).
Capacidad por rack: típicamente entre 80 kW y 130 kW para servidores de alta densidad. Los servidores con B200 o próximas generaciones pueden llegar a 150+ kW por rack. La limitación práctica ya no es térmica sino eléctrica: a 130 kW por rack, los breakers de 60A no dan abasto, y necesitas PDUs de alta capacidad (generalmente 415V trifásico directo al rack).
Las 5 diferencias operativas que importan
1. Costo del CDU y del lazo de distribución
Un sistema L2C necesita menos flujo de líquido (menor caudal) y puede operar con CDUs más pequeños. Un sistema D2C necesita 3 a 5 veces más caudal, lo que requiere bombas más grandes, tubería de mayor diámetro, y CDUs de mayor capacidad. La diferencia en CAPEX del sistema de cooling es típicamente de 1.5x a 2.5x entre L2C y D2C para la misma cantidad de racks.
2. Riesgo de fuga
Más cold plates = más puntos de potencial fuga. Un sistema D2C en un rack DGX tiene 9 quick-disconnects por servidor. Si cada uno tiene una tasa de falla de 0.1% al año, en un cluster de 100 servidores tienes 90 puntos de falla. La práctica correcta es instalar sensores de humedad en el piso del rack, y contención secundaria (bandeja de goteo) en cada servidor. Pero el riesgo operacional es real y debe presupuestarse.
3. Compatibilidad con servidores existentes
L2C funciona con servidores estándar con un cold plate en el socket del CPU, que es la mayoría del mercado. DLC y D2C requieren servidores diseñados para cold plate extended, que es un subconjunto del mercado (típicamente servidores de alta densidad OEM como Dell PowerEdge XE, HPE Cray, Supermicro, Lenovo ThinkSystem, o NVIDIA DGX). Si tu cluster es heterogéneo con servidores de propósito general, L2C es la única opción realista; DLC y D2C requieren un upgrade de hardware.
4. Eficiencia energética del cooling
Un sistema bien diseñado, D2C es marginalmente más eficiente en PUE que L2C porque el calor se extrae a una temperatura más alta del líquido (CPU+GPU+HBM vs solo CPU), lo que permite free cooling más tiempo. La diferencia es 0.01 a 0.03 en PUE, que parece marginal pero en un site de 10 MW son 100 a 300 kW de ahorro continuo.
5. Complejidad de mantenimiento
L2C es el más simple: cambiar un servidor es desconectar 2 mangueras y desconectar energía. D2C requiere procedimiento para drenar el cold plate antes de sacar el servidor (o tener un sistema de bypass que aísle el servidor del lazo sin drenar el cluster entero). DLC está en medio. La complejidad operativa impacta el MTTR (Mean Time To Repair) de cambios planeados.
Cuándo conviene cada una (regla de decisión)
- L2C: clusters heterogéneos con servidores de propósito general, densidad entre 20-40 kW por rack, presupuesto de cooling ajustado. Es la opción más conservadora y funciona con casi cualquier servidor moderno.
- DLC: clusters de cómputo de propósito general densos (HPC, virtualización enterprise, VDI), 40-70 kW por rack, servidores diseñados para extended cold plate. Balance entre densidad y compatibilidad.
- D2C: clusters de GPU para IA (entrenamiento o inferencia a escala), 80-130 kW por rack, servidores DGX o equivalentes. Es la única opción que soporta esa densidad. La inversión es alta, pero no hay alternativa.
- Comprar D2C cuando solo necesitas L2C. El error más caro. Si tu densidad objetivo es 35 kW por rack, L2C es suficiente. Comprar D2C para 35 kW te deja con CAPEX inflado en CDU, bombeo, tubería, y contención, sin beneficio operativo.
- Asumir que un servidor “liquid-cooled” es D2C. Muchos servidores en el mercado se venden como «liquid cooling ready» pero vienen con cold plate solo en el CPU. Eso es L2C, no D2C. Verifica el datasheet: si el cold plate solo cubre el CPU, es L2C. Si cubre CPU+memoria o CPU+GPU, es DLC o D2C respectivamente.
- Subdimensionar el CDU para D2C. El error técnico más caro. Un servidor DGX H100 consume 10-11 kW de cooling por unidad. Un rack con 4 de esos servidores consume 40-44 kW. Si dimensionas el CDU al 80% de eso “para tener margen”, te quedas corto cuando el cluster llegue a 80% de carga. Dimensiona para el peak sostenido real, no para el nominal con margen.
Los 3 errores más comunes al elegir
El veredicto
Las tres arquitecturas (L2C, DLC, D2C) no son intercambiables. Cada una está optimizada para un rango de densidad y un tipo de servidor distinto. La decisión correcta depende de tres variables: tu densidad objetivo por rack, el tipo de servidores que operas o vas a operar, y tu CAPEX disponible para el sistema de cooling. Si tu carga es heterogénea con mezcla de CPU y GPU, L2C + DLC en los racks de GPU es la combinación más común en producción. Si tu carga es 100% GPU para IA, D2C es la única respuesta. Y si tu densidad es menor a 25 kW por rack, ninguna de las tres te conviene; el aire bien diseñado sigue siendo más barato y más simple.
Fuentes
ASHRAE TC 9.9 — Thermal Guidelines for Data Processing Environments (5th Edition, 2021, liquid cooling classifications) —.https://www.ashrae.org/technical-resources/bookstore/thermal-guidelines-for-data-processing-environments.
NVIDIA — DGX H100/H200 System Design Guide (D2C architecture, cold plate specifications) —.https://docs.nvidia.com/dgx/.
Open Compute Project — Liquid Cooling Specifications (open standard for DLC/D2C) —.https://www.opencompute.org/.
Uptime Institute — Data Center Site Infrastructure Tier Standard (consideraciones de cooling líquido) —.https://uptimeinstitute.com/resources/asset/tier-classification-system.
TIA-942-B-2023 — Telecommunications Infrastructure Standard for Data Centers (liquid cooling en Section 6) —.https://www.tia.org/standards.
¿Quieres dominar este tema?
Noxtel Academy →