Checklist diario del operador en aire de precisión: las 5 cosas que debes ver en el display antes de las 9 AM
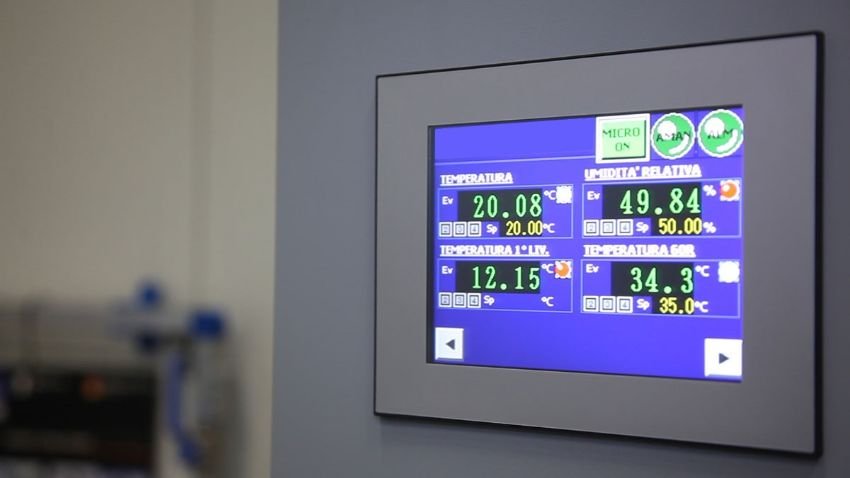
El operador de un data center que mira el display del aire de precisión y anota ‘todo OK’ está aceptando un riesgo innecesario. El display te muestra 5 métricas operativas críticas en tiempo real, pero NO te dice nada sobre filtros sucios, drenaje tapado, o vibraciones anormales que son las causas #1 de fallas catastróficas. Este artículo cubre las 5 cosas que SÍ debes ver en el display cada turno, las 3 que NO te dice el display pero requieren verificación física adicional, y el formato de bitácora que tu operador debe usar para que esta información sea útil para auditoría.
El checklist aplica a unidades CRAC/CRAH típicas (Vertiv Liebert, Stulz CyberAir, Schneider, etc.). Las alarmas varían ligeramente entre modelos pero las métricas operativas básicas son las mismas.
Lo que SÍ te dice el display (las 5 métricas críticas)
El display de un CRAC moderno muestra estas 5 métricas operativas:
- Temperatura de retorno del aire (aire que sale de los racks y vuelve al CRAC). Típico rango ASHRAE A1: 18-27°C. Valores fuera de este rango disparan alarma.
- Temperatura de suministro (aire frío que sale del CRAC hacia los racks). Típico: 15-22°C dependiendo del diseño. La diferencia entre retorno y suministro indica la capacidad de enfriamiento efectiva.
- Humedad relativa. Típico ASHRAE: 40-55%. Fuera de este rango, riesgo de ESD (baja humedad) o condensación (alta humedad).
- Presión de refrigerante (manómetro en modelo físicos, lectura digital en modelos nuevos). Típico R-134a: 60-100 psi en lado de baja presión, 200-400 psi en lado de alta presión.
- Alarmas activas. Lista de códigos de alarma en el log del display. Cada código tiene significado específico según manual del fabricante.
Las 5 métricas en el display son las que el operador puede ver sin herramientas adicionales. Pero ver no es lo mismo que entender. Cada métrica tiene contexto operacional que el operador debe saber interpretar.
Cómo interpretar la temperatura de retorno
La temperatura de retorno te dice qué tan caliente está el aire que vuelve al CRAC:
- Si está entre 22-26°C: operación normal. El data center está expulsando el calor correctamente.
- Si está entre 26-30°C: alerta. Los racks están generando más calor del esperado o el sistema de extracción de calor está fallando.
- Si está sobre 30°C: alarma. Requiere acción inmediata del operador. Posible sobrecarga o falla del sistema de extracción.
El error típico: el operador ve 28°C en el display y anota ‘OK’. 28°C es alerta, no OK. La acción inmediata es verificar carga de los racks y sistema de extracción. Sin acción, el calor sigue subiendo y llega a 35-40°C en horas.
Cómo interpretar la diferencia entre retorno y suministro
La diferencia (delta T) entre retorno y suministro te dice la eficiencia:
- Delta T de 8-12°C: operación eficiente. El CRAC está extrayendo la cantidad correcta de calor.
- Delta T menor a 6°C: baja eficiencia. Posibles causas: carga baja (racks vacíos), filtros sucios restringiendo flujo, serpentina con hielo (falla de refrigerante).
- Delta T mayor a 15°C: alta eficiencia aparente pero enmascara problema. La carga es mayor de la que el CRAC puede manejar, posiblemente con puntos calientes no detectados.
El operador debe anotar el delta T diario. Si cambia significativamente de un día a otro, hay cambio operacional (nuevo rack, equipo retirado, filtro tapado). La bitácora con histórico permite detectar tendencias.
Cómo interpretar la humedad
La humedad fuera de rango genera 3 problemas diferentes:
- Humedad menor a 35%: riesgo de ESD (descarga electrostática). El aire seco no disipa la carga acumulada en personas y superficies. Componentes electrónicos sensibles pueden dañarse por descarga.
- Humedad mayor a 60%: riesgo de condensación. Si la temperatura del rack desciende por debajo del punto de rocío, se forma agua en superficies metálicas. Esto daña componentes y crea riesgo de corto circuito.
- Humedad fuera de rango por tiempo prolongado: daño acumulado a componentes. Aunque la exposición corta es tolerable, la exposición continua degrada componentes electrónicos.
El operador debe notar cambios en humedad. Si la humedad sube progresivamente, puede ser falla del sistema de humidificación o aumento de carga térmica. Si baja progresivamente, puede ser falla del humidificador o aire exterior muy seco infiltrándose.
Cómo interpretar la presión de refrigerante
La presión del refrigerante es indicador temprano de problemas:
- Presión normal en operación estable. Si la lectura es estable durante 24+ horas, el sistema está bien.
- Presión baja progresiva (disminuye día a día): fuga de refrigerante. La presión cae porque el gas se está escapando lentamente. Acción: buscar fuga con detector electrónico.
- Presión alta con alarma de alta presión: problema en condensador (sucio, bloqueado, o ventilador fallando).
- Presión fluctuante: termistor errático o controlador del compresor con falla.
El operador debe anotar la presión diaria y detectar tendencias. La presión que cae de 100 psi a 80 psi en 2 semanas es fuga lenta. La presión que cae a 50 psi en 1 día es fuga mayor que requiere acción inmediata.
Lo que NO te dice el display (las 3 cosas que requieren verificación física)
El display te miente sobre 3 cosas críticas:
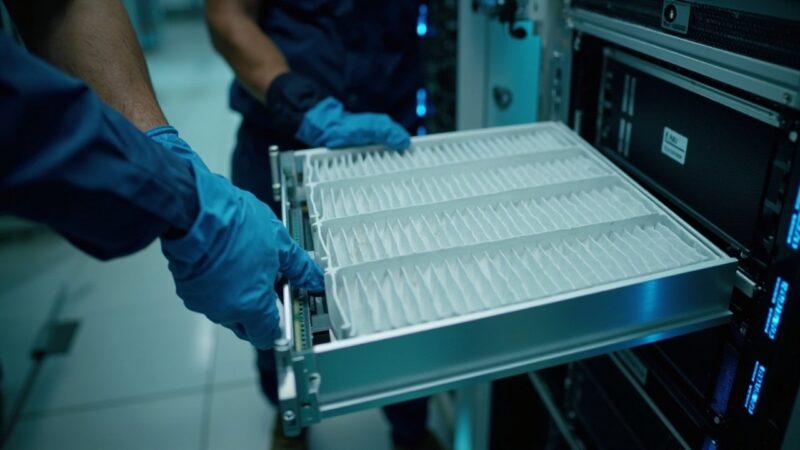
- Filtros de aire sucios. El filtro puede estar 80% obstruido y el CRAC sigue operando con menor flujo. El display no muestra ‘filtro sucio’. Acción: inspección visual del filtro cada 2 semanas.
- Drenaje de condensado tapado. La bomba puede estar fallando lentamente y el agua empieza a acumularse. El display no muestra ‘bomba fallando’. Acción: inspección visual del drenaje y bomba cada 2 semanas.
- Vibración anormal del compresor o ventilador. El operador puede escucharla pero el display no la detecta. Acción: auditiva cada turno (el operador escucha la unidad durante la inspección).
Las 3 verificaciones físicas son las que separan al operador junior del senior. El junior anota ‘todo OK’ solo viendo el display. El senior verifica display + filtros + drenaje + sonido.
El checklist diario completo (formato de bitácora)
Lo que el operador debe anotar cada turno:
- Hora de la inspección. Timestamp con HH:MM.
- Temperatura de retorno y suministro. Anotar ambos valores numéricos. Calcular delta T.
- Humedad relativa. Valor numérico.
- Presión de refrigerante (si está disponible en el display). Anotar lectura numérica.
- Alarmas activas. Listar códigos o descripción. Si no hay alarmas, anotar ‘sin alarmas’.
- Inspección visual de filtro. ‘Limpio’, ‘polvo visible’, ‘obstruido’. Si está obstruido, escalar.
- Inspección visual de drenaje. ‘Seco’, ‘húmedo’, ‘goteo visible’, ‘charco’. Si hay goteo o charco, escalar.
- Inspección auditiva. ‘Normal’, ‘vibración anormal’, ‘ruido metálico’. Si hay ruido anormal, escalar.
Este formato genera 8 datos por turno × 3 turnos × 365 días = 8,760 entradas anuales por CRAC. Es volumen pero es la única forma de tener histórico para detectar tendencias y para auditoría de incidentes.
Cuándo escalar una anomalía detectada
Criterios de escalación inmediata:
- Temperatura de retorno mayor a 30°C: escalar a supervisor de operación. Acción correctiva en menos de 1 hora.
- Humedad menor a 30% o mayor a 65%: escalar. Riesgo de daño a equipos.
- Cualquier alarma activa en el display: escalar. Las alarmas existen por alguna razón.
- Filtro visiblemente obstruido: escalar a mantenimiento para cambio.
- Agua visible en el piso bajo la unidad: escalar inmediatamente. Riesgo de arco eléctrico.
- Ruido anormal: escalar. Posible desgaste de componente mecánico antes de falla catastrófica.
El operador NO debe esperar al siguiente turno para escalar. Las 6 condiciones son urgentes. La cultura de ‘lo veo en la siguiente vuelta’ es la que genera incidentes mayores.
Cómo organizar la bitácora para auditoría
El formato de bitácora debe cumplir requisitos de compliance:
- Almacenamiento por mínimo 3 años (5 años para SOC 2, 7 años para algunas regulaciones financieras).
- Acceso solo a personal autorizado. La bitácora contiene información operativa sensible.
- Formato digital (no papel) preferiblemente. Permite búsqueda, análisis de tendencia, y reporte automatizado.
- Respaldo automático. Si la bitácora se pierde por falla del sistema, no hay forma de demostrar compliance durante auditoría post-incidente.
Una herramienta común es la app móvil con campos pre-definidos y timestamp automático. Costo típico: $30,000-80,000 MXN por licencia anual para DC mediano. Alternativa: hoja Excel compartida con macros de validación (más barato pero menos robusto).
El error más caro: ‘todo OK’ cuando no lo es
El error #1 que veo en DCs: operador anota ‘todo OK’ rutinariamente sin realmente verificar. Razones:
- Falta de capacitación sobre cómo interpretar las métricas.
- Falta de tiempo (operador tiene 10 DCs que revisar en 1 hora).
- Presión por cerrar tickets rápido (cultura de no documentar problemas).
El resultado: cuando hay incidente, la bitácora dice ‘todo OK’ 30 minutos antes. No hay forma de demostrar que se detectó a tiempo. La auditoría de incidente falla. La aseguradora puede negar cobertura si considera que el operador fue negligente.
Solución: capacitar al operador en interpretación de métricas, dar tiempo suficiente para inspección (no 5 minutos sino 15-20 minutos por unidad), y cultura donde documentar problema es premiado, no penalizado.
Cuándo el display NO es suficiente y necesitas termómetros externos
Hay 3 escenarios donde el display del CRAC no es suficiente para verificar temperatura:
- Puntos calientes localizados. El display mide temperatura promedio de retorno. Un rack específico puede estar a 35°C mientras el promedio es 24°C. Solución: termómetros en racks individuales (sensores de temperatura por rack).
- Falla del sensor del CRAC. Si el termistor del CRAC está descalibrado, el display muestra 22°C pero la realidad es 28°C. Solución: termómetro independiente calibrado (termómetro de mercurio o digital calibrado) para verificar periódicamente.
- Compliance estricto (SOC 2, ISO 27001). Estos marcos requieren verificación independiente de las métricas operativas, no solo del display del fabricante.
El termómetro externo calibrado es barato ($500-2,000 MXN) y resuelve los 3 escenarios. Debe estar disponible para verificación cuando el operador sospecha problema.
El plan de mantenimiento que el checklist complementa
El checklist diario no reemplaza el mantenimiento preventivo programado:
- Cada 3 meses: limpieza de filtros y drenaje. El operador diario detecta cuándo se necesita.
- Cada 6 meses: verificación de presión de refrigerante con manifold. El operador diario anota tendencia.
- Cada 12 meses: inspección profunda con detector electrónico de fugas. El operador diario detecta síntomas.
El checklist diario es el ‘radar’ que detecta problemas. El mantenimiento programado es el ‘mecánico’ que los resuelve. Sin el radar, el mecánico no sabe cuándo intervenir. Sin el mecánico, el radar detecta pero no resuelve.
El checklist como herramienta de capacitación
El checklist también sirve para capacitar operador nuevo:
- El checklist estandariza lo que se verifica. Operador nuevo sabe qué mirar desde el día 1.
- La bitácora histórica permite comparar. Operador nuevo puede ver ‘la temperatura de retorno estaba a 25°C hace 6 meses, ahora está a 28°C — investigar por qué’.
- El supervisor puede revisar la bitácora y detectar patrones de operador junior (anotaciones vagas, falta de datos numéricos).
El checklist bien implementado convierte la operación diaria en proceso de aprendizaje continuo. El operador senior enseña al junior no por observación sino por la calidad de las bitácoras.
Resumen: las 5+3 que tu operador debe verificar
El mínimo viable:
- 5 métricas en el display: temperatura retorno, temperatura suministro, humedad, presión refrigerante, alarmas activas.
- 3 verificaciones físicas: filtros, drenaje, sonido.
- Bitácora con timestamp y valores numéricos, no ‘todo OK’.
- Escalación inmediata si cualquiera de los 6 criterios de alarma aplica.
El operador que ejecuta las 5+3 diariamente, con bitácora documentada y escalación cuando aplica, está cumpliendo con el estándar de data center maduro. El que solo anota ‘todo OK’ está aceptando riesgo innecesario y creando problema en auditoría post-incidente.
Fuentes
- ASHRAE TC 9.9 — https://www.ashrae.org/technical-resources/bookstore/thermal-vigilance-for-data-processing-environments
- TIA-942-B-2023 — https://www.tia.org/standards/tia-942
- BICSI 002-2024 — https://www.bicsi.org/standards/data-center
- Uptime Institute — https://datacenter.uptimeinstitute.com/
- ISO/IEC 20000-1:2018 — https://www.iso.org/standard/70636.html
¿Quieres dominar este tema?
Noxtel Academy →